分类太细反而难找!我用豆包+飞书知识库把541个GPT提示词案例重新归了类
本文改编自开源《豆包工作蓝皮书》(AlephAITech/DoubaoWorkGuide),原作者:刘聪NLP / 甲木 / 苍何 / 袋鼠帝 / 摸鱼小李
刚开始收集 GPT-Image2 提示词案例时,我总觉得越多越好。等数量攒到541 个,问题也跟着来了:有的放在 GitHub 仓库里,有的埋在 README 文档中,还有一些散落在本地文件夹。真想找一条适合某种画风或使用场景的提示词时,往往要在几个地方来回翻;原来的分类又分得太细,越往下找越容易迷路。
这次,我把这些案例交给豆包工作,让它先读懂每条提示词适合做什么,再按照实际查找习惯重新归类,最后整理进飞书知识库。接下来会完整展示这次整理过程,看看这541 个案例怎样从“收藏了很多”变成“需要时能马上找到”。
本节以分散在 GitHub 仓库、README 文档和本地文件夹中的541个 GPT-Image2 提示词案例为例,介绍如何使用豆包工作完成内容整理,并借助飞书知识库进行分类管理。下面跟着我来实操一下。
前置条件
- 为了豆包和飞书数据链路打通,豆包登录的账号,和你要使用的飞书知识库需要是同一个账号。
- 项目资料已经上传到飞书云盘或知识库(没有的话先上传,方法见 2.1 节)。
- 进入豆包工作模式。
先说说我原来的awesome-gpt-image-2有多乱
这个项目名为 awesome-gpt-image-2,是一个 GPT-Image2 的提示词库,目前累计收录了541 个逆向拆解的案例,同时配套 20 多套可直接复用的工业级模板。项目在GitHub上已经收获了25.8k Star。
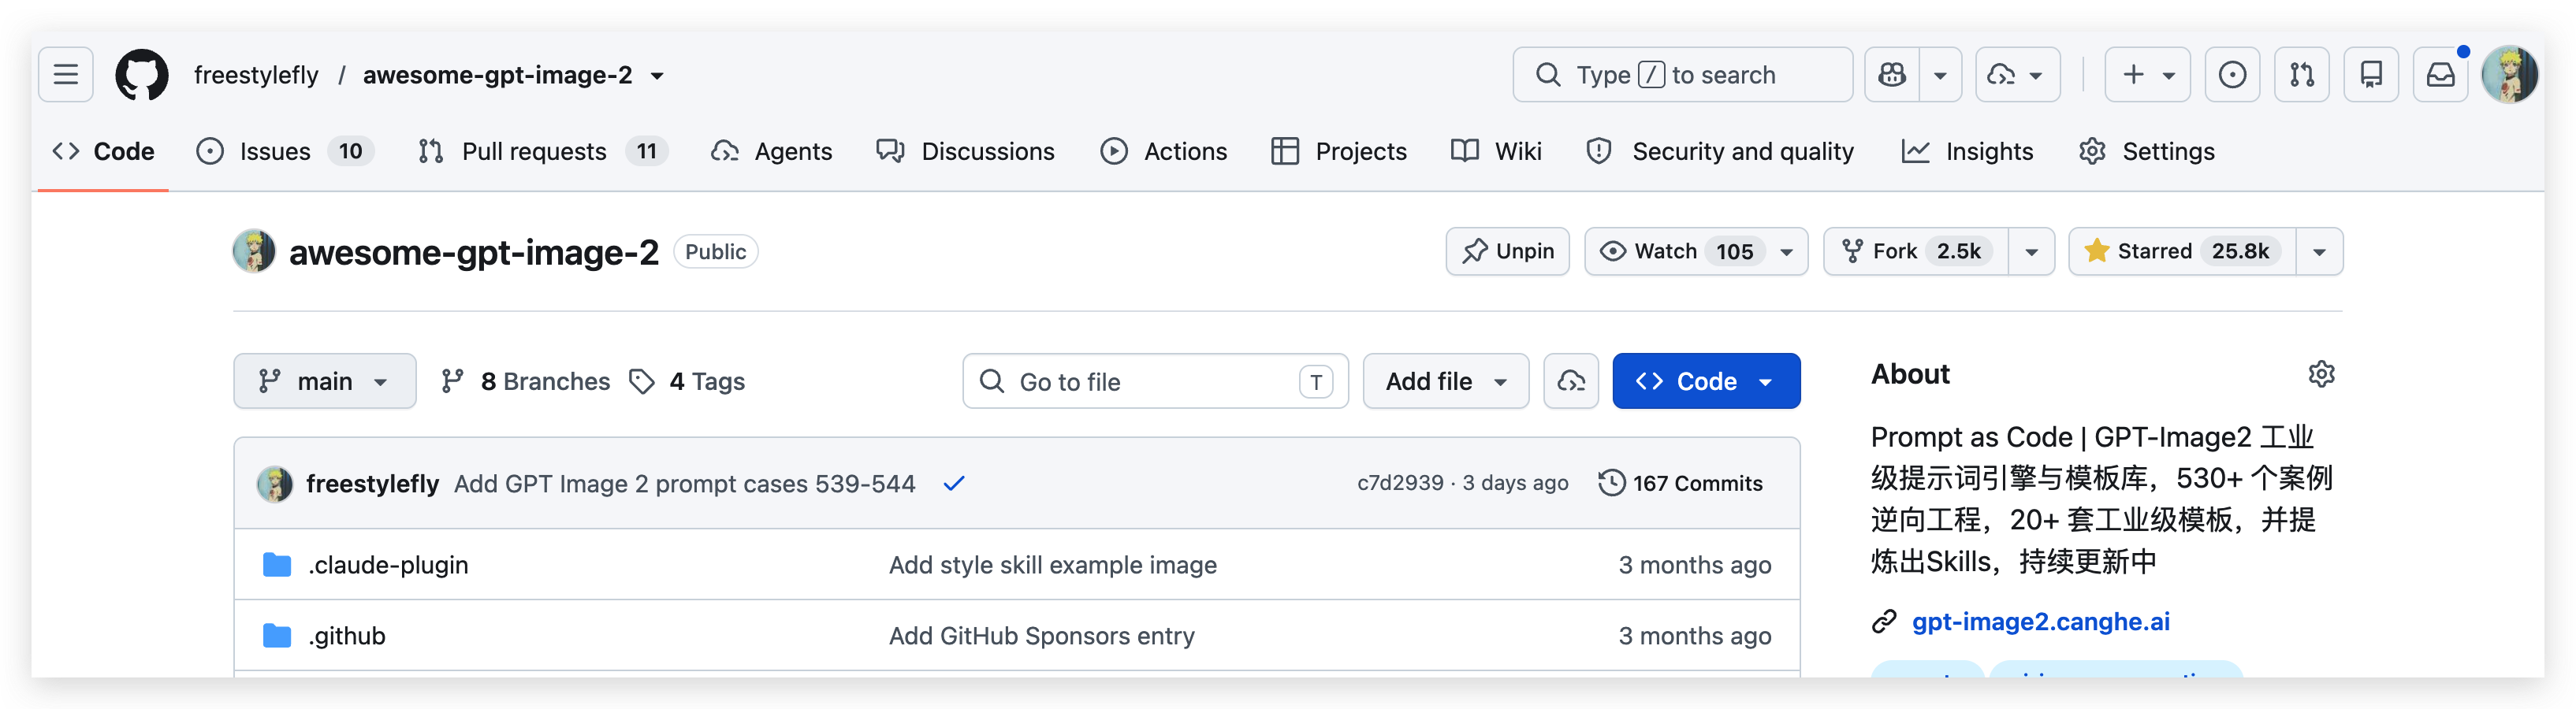
说说原来我是怎么管的呢?说出来有点不好意思:
- 案例全堆在 README 和
docs/gallery-part-1.md、gallery-part-2.md里,靠手动分了 13 个类。 - 风格标签 19 个、场景标签 10 个,和分类三套维度互相交叉,找东西的时候根本不知道该从哪进。
- 本地还有一堆图片、脚本、数据文件,和 GitHub 上的版本经常对不上。
- 想找一个"国风水墨海报"的案例,得在 History 类和 Illustration 类之间来回翻,还不一定找得到。
总体来看,这套分类体系是按照时间顺序搭建的,没有站在后续实际检索、使用内容的用户视角做过设计。分类维度越叠越多,最后反而变成了查找内容的最大障碍。
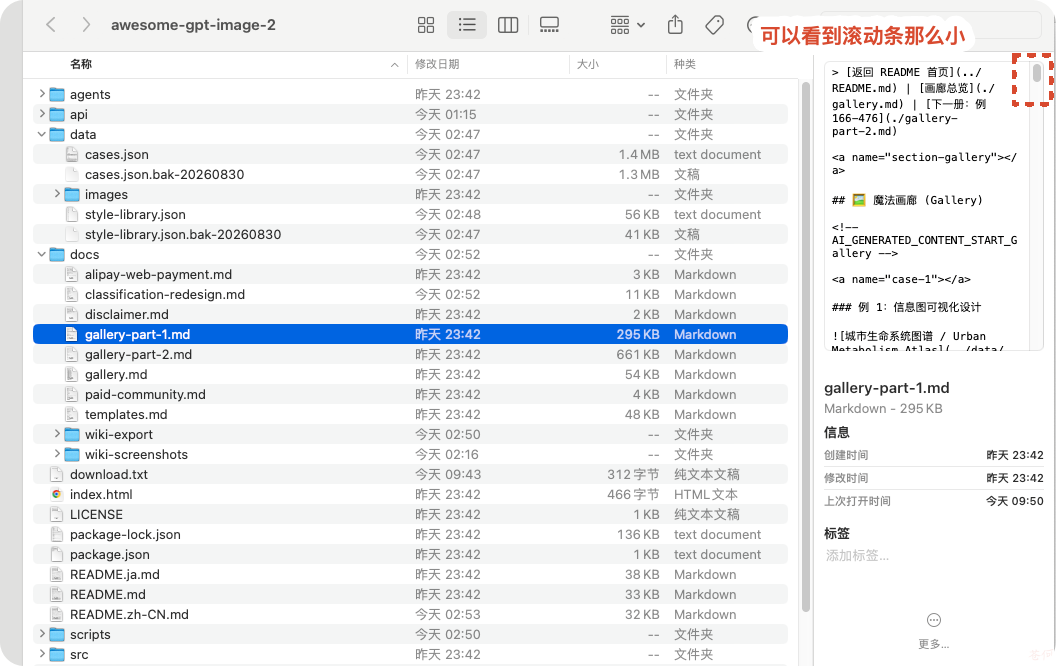
图1-第1张|展示原来项目散乱的状态
第一步:把零散资料收拢扔进豆包
豆包和飞书打通之后,最核心的效率提升就是告别手动复制粘贴搬运内容的重复劳动,所有飞书内的资源都可以通过 @ 直接完成关联调用。
通过@选择 飞书文档、云盘、对话
在豆包的输入框中输入 @ 符号,你会发现可关联的对象远不止飞书文档:飞书联系人、云盘内的任意文件、过往的历史对话记录,全部都可以通过 @ 直接引入。所有飞书内的上下文信息都能直接加载到豆包的工作会话中,操作空间一下子就大了。
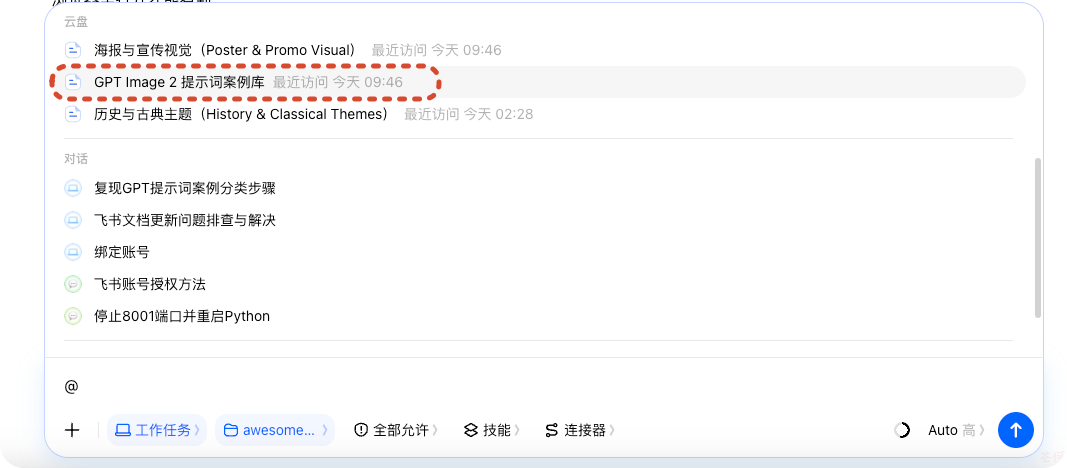
图2-第1张|在豆包输入框中点击 @,展示可以选择飞书文档、云盘文件、联系人、对话等多种来源的界面
我这个项目的资料比较散,我是这么做的:
- 先把 GitHub 仓库里的
data/cases.json(541 个案例的结构化数据)和docs/目录下载到本地; - 上传到飞书云盘,或者直接在飞书知识库里建一个空间;
- 在豆包里 @ 这个知识库/文档,让它能读到全部案例数据。
实操:一句话让豆包开始干活
全程不用写复杂提示词,我就发了这一句话:
帮我分析这个项目的案例分类体系 @awesome-gpt-image-2 项目资料
先看看现有分类有什么问题,再根据真实搜索词重新设计
豆包会自动去读案例数据、统计分类分布、找出同义词和交叉项,比我自己手动翻快多了。
第二步:让豆包诊断现有分类的毛病
豆包拿到数据之后,先做了一轮量化诊断。我本来以为它会给我一些泛泛的建议,结果它直接把数据跑出来了,问题一目了然。
它发现了五个硬伤
🌰 示例
第一,同义词标签满天飞。 19 个风格标签里,Character 用了 113 次、Characters 只用了 2 次——完全是同一个东西;Product 和 Products、Infographic 和 Charts、Realistic 和 Photography、History 和 Classical,全都是重复的。19 个标签其实 12 个就够了。 第二,同一个概念出现在三个维度里。 比如"海报",category 里有 Posters & Typography,styles 里有 Poster;"历史"在 category、styles、scenes 三层都出现了。一个案例被三个维度反复交叉,用户根本不知道该从哪个入口找。 第三,垃圾桶分类。 Other Use Cases 塞了 28 个案例,啥都有,等于没分类。 第四,薄分类撑不起一级目录。 Architecture & Spaces 只有 12 个、Documents & Publishing 11 个、History & Classical Themes 16 个、Scenes & Storytelling 21 个——加起来才占 11%,但作为一级分类占了 4 个坑位。 第五,内部术语用户看不懂。 Other Use Cases、R&D、Prompt as Code 这些词,普通用户搜的时候根本不会用,也搜不到。
接下来看看 豆包读取后出来的汇总图表📊
ℹ️ 原文此处嵌入飞书表格/多维表格视图,可在开源仓库原文查看:https://github.com/AlephAITech/DoubaoWorkGuide
图3-第1张|展示豆包输出的分类诊断结果
分类有了用户是怎么查找内容呢?
好的内容需要看见、被检索,被使用;不然如同垃圾存在。
这个就是豆包在做的有价值的事:它直接从541个案例的真实标题里,把用户高频搜索的关键词全部提取出来,反向推导出了大家真正的检索习惯。
结果很清楚:用户打开这个提示词库的时候,脑子里带着明确的落地目标,第一反应就是“我要做一张XX图”。
- 搜"海报""封面""宣传"的最多(82 次)
- 然后是"信息图""技术图解"(48 次)
- "界面""截图""App"(38 次)
- "人像""肖像""头像"(28 次)
- "插画""国风""水墨"(25 次)
顺着这份真实的用户检索数据,我们的分类体系围绕产出物、对应落地任务来搭建,所有分类名直接对应用户要完成的最终目标。这个从用户真实搜索行为出发的思路转变,就是这次整个分类重构的核心支点。
第三步:从真实搜索词出发,重新设计分类
新分类:13 个 → 8 个,全部按产出物命名
豆包给出的新分类是这样的:
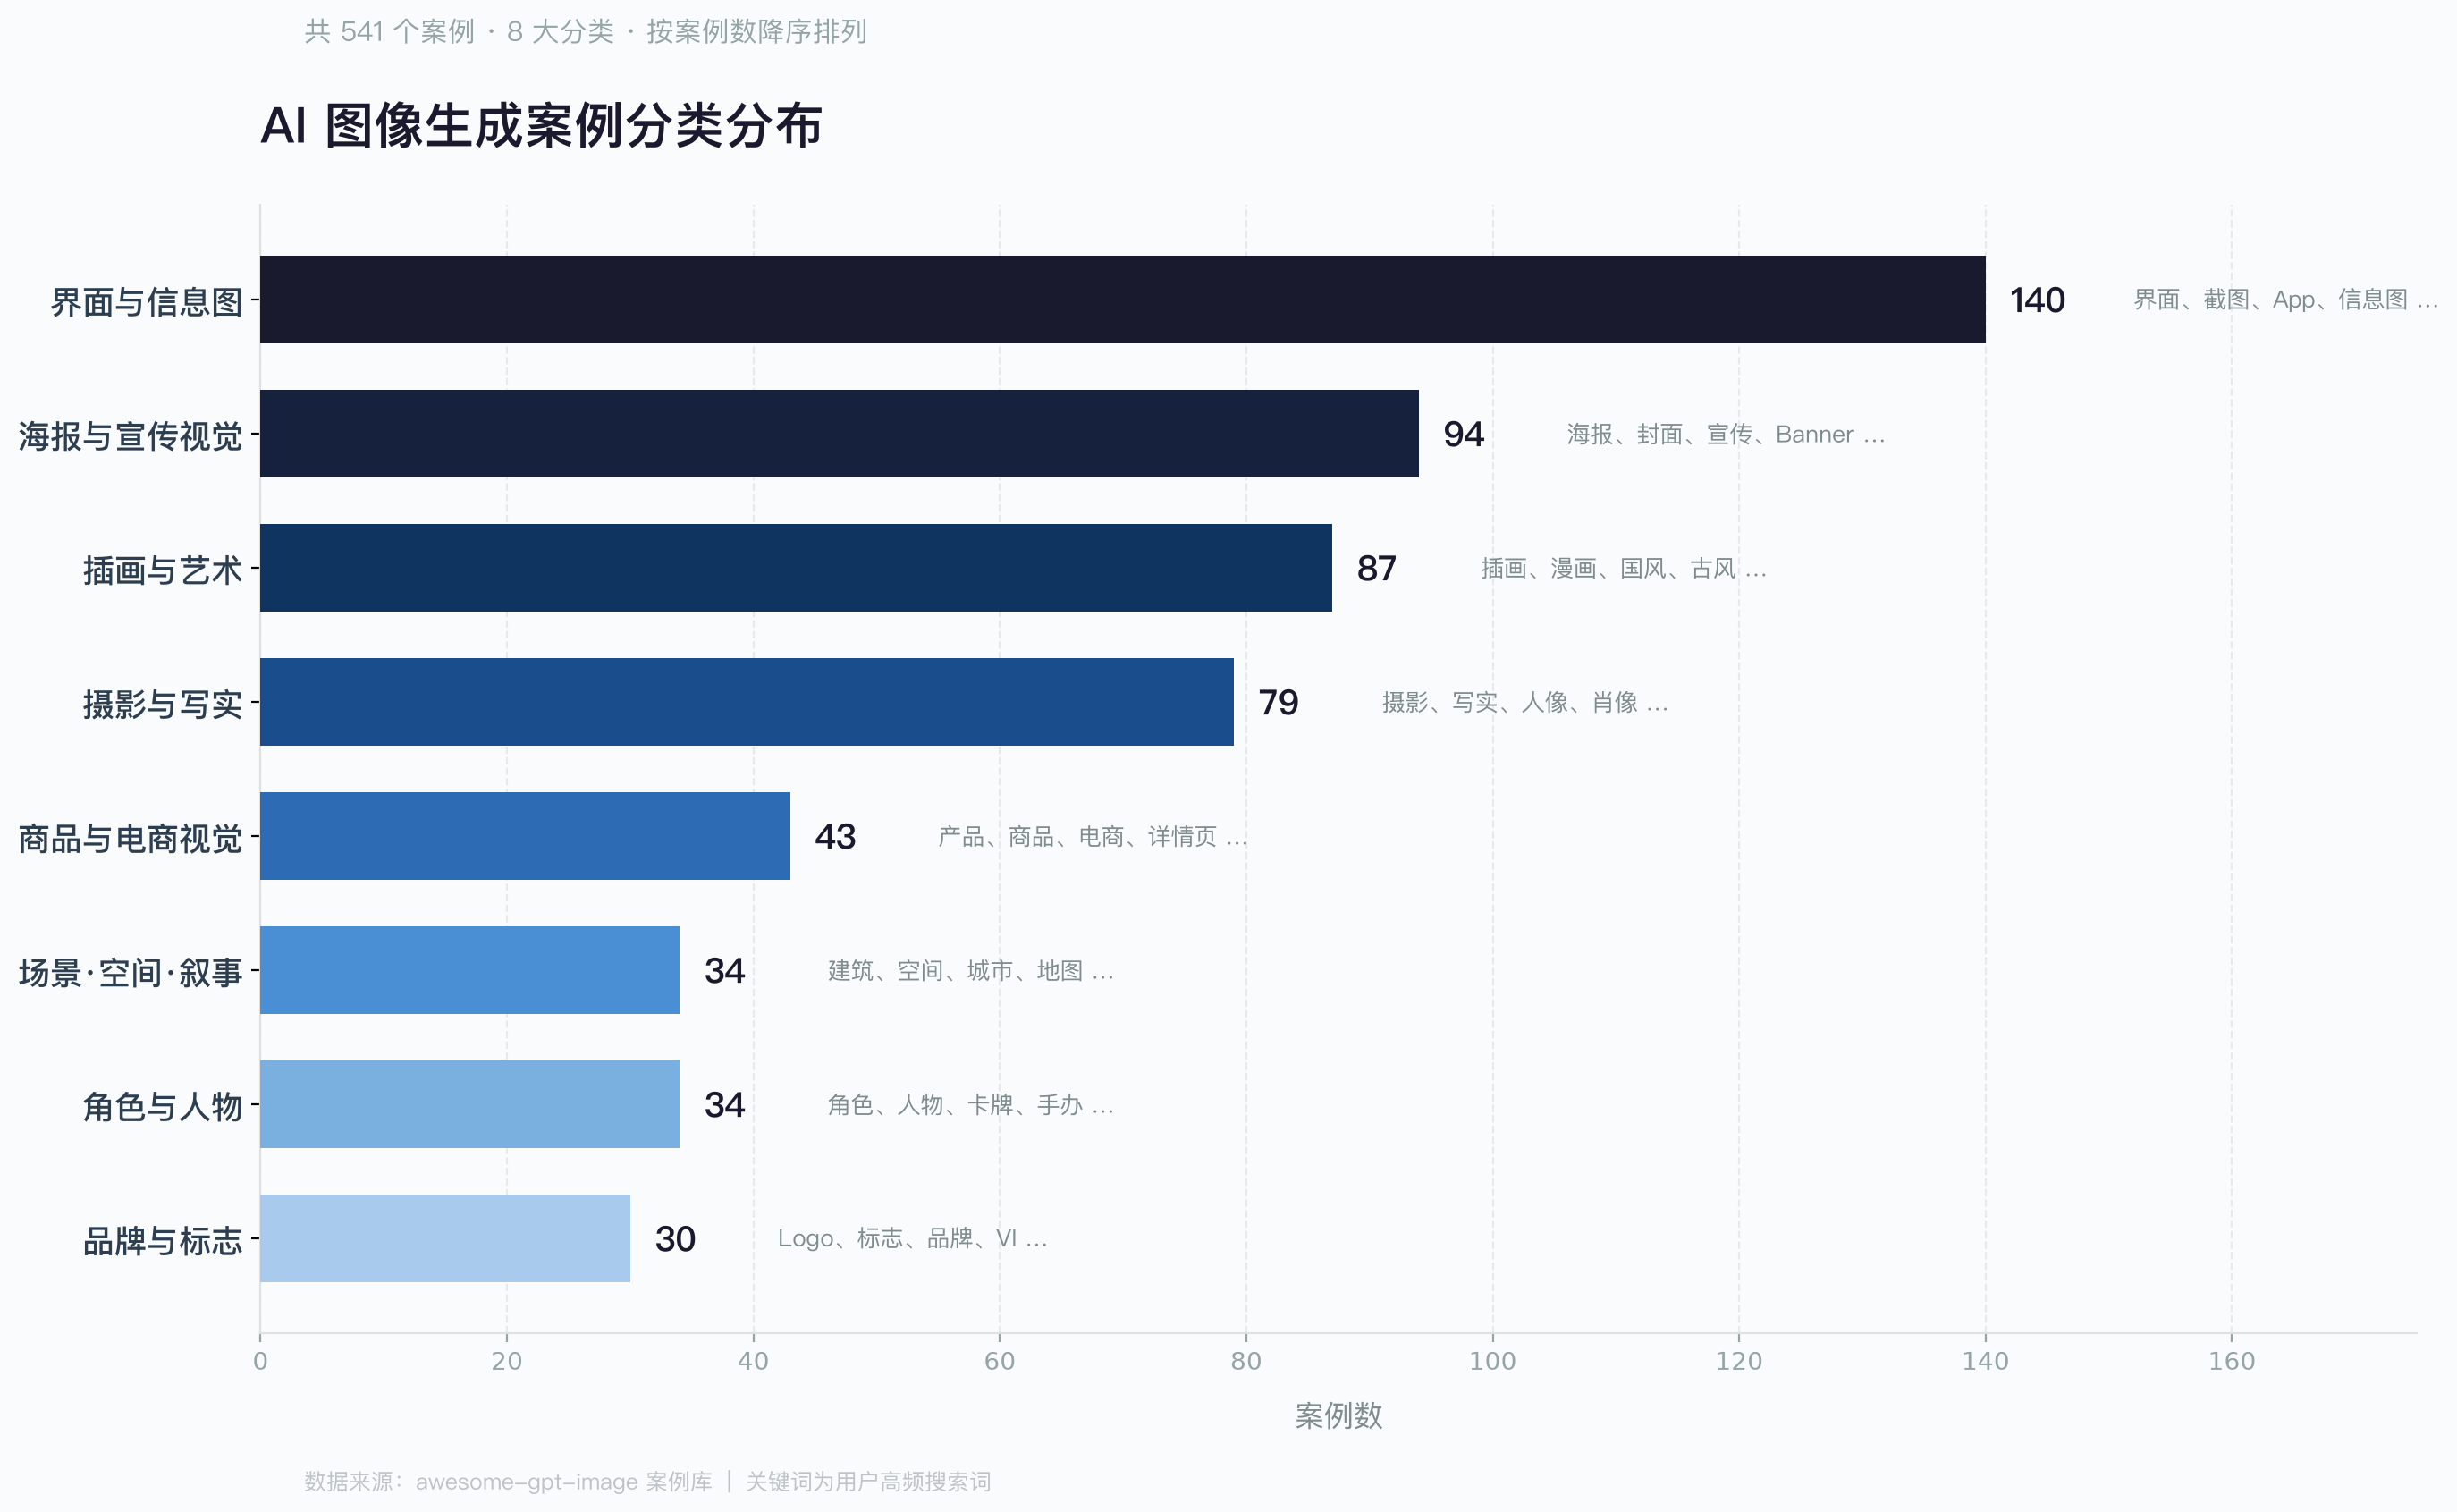
合计 541 个,一个不多一个不少,没有垃圾桶。
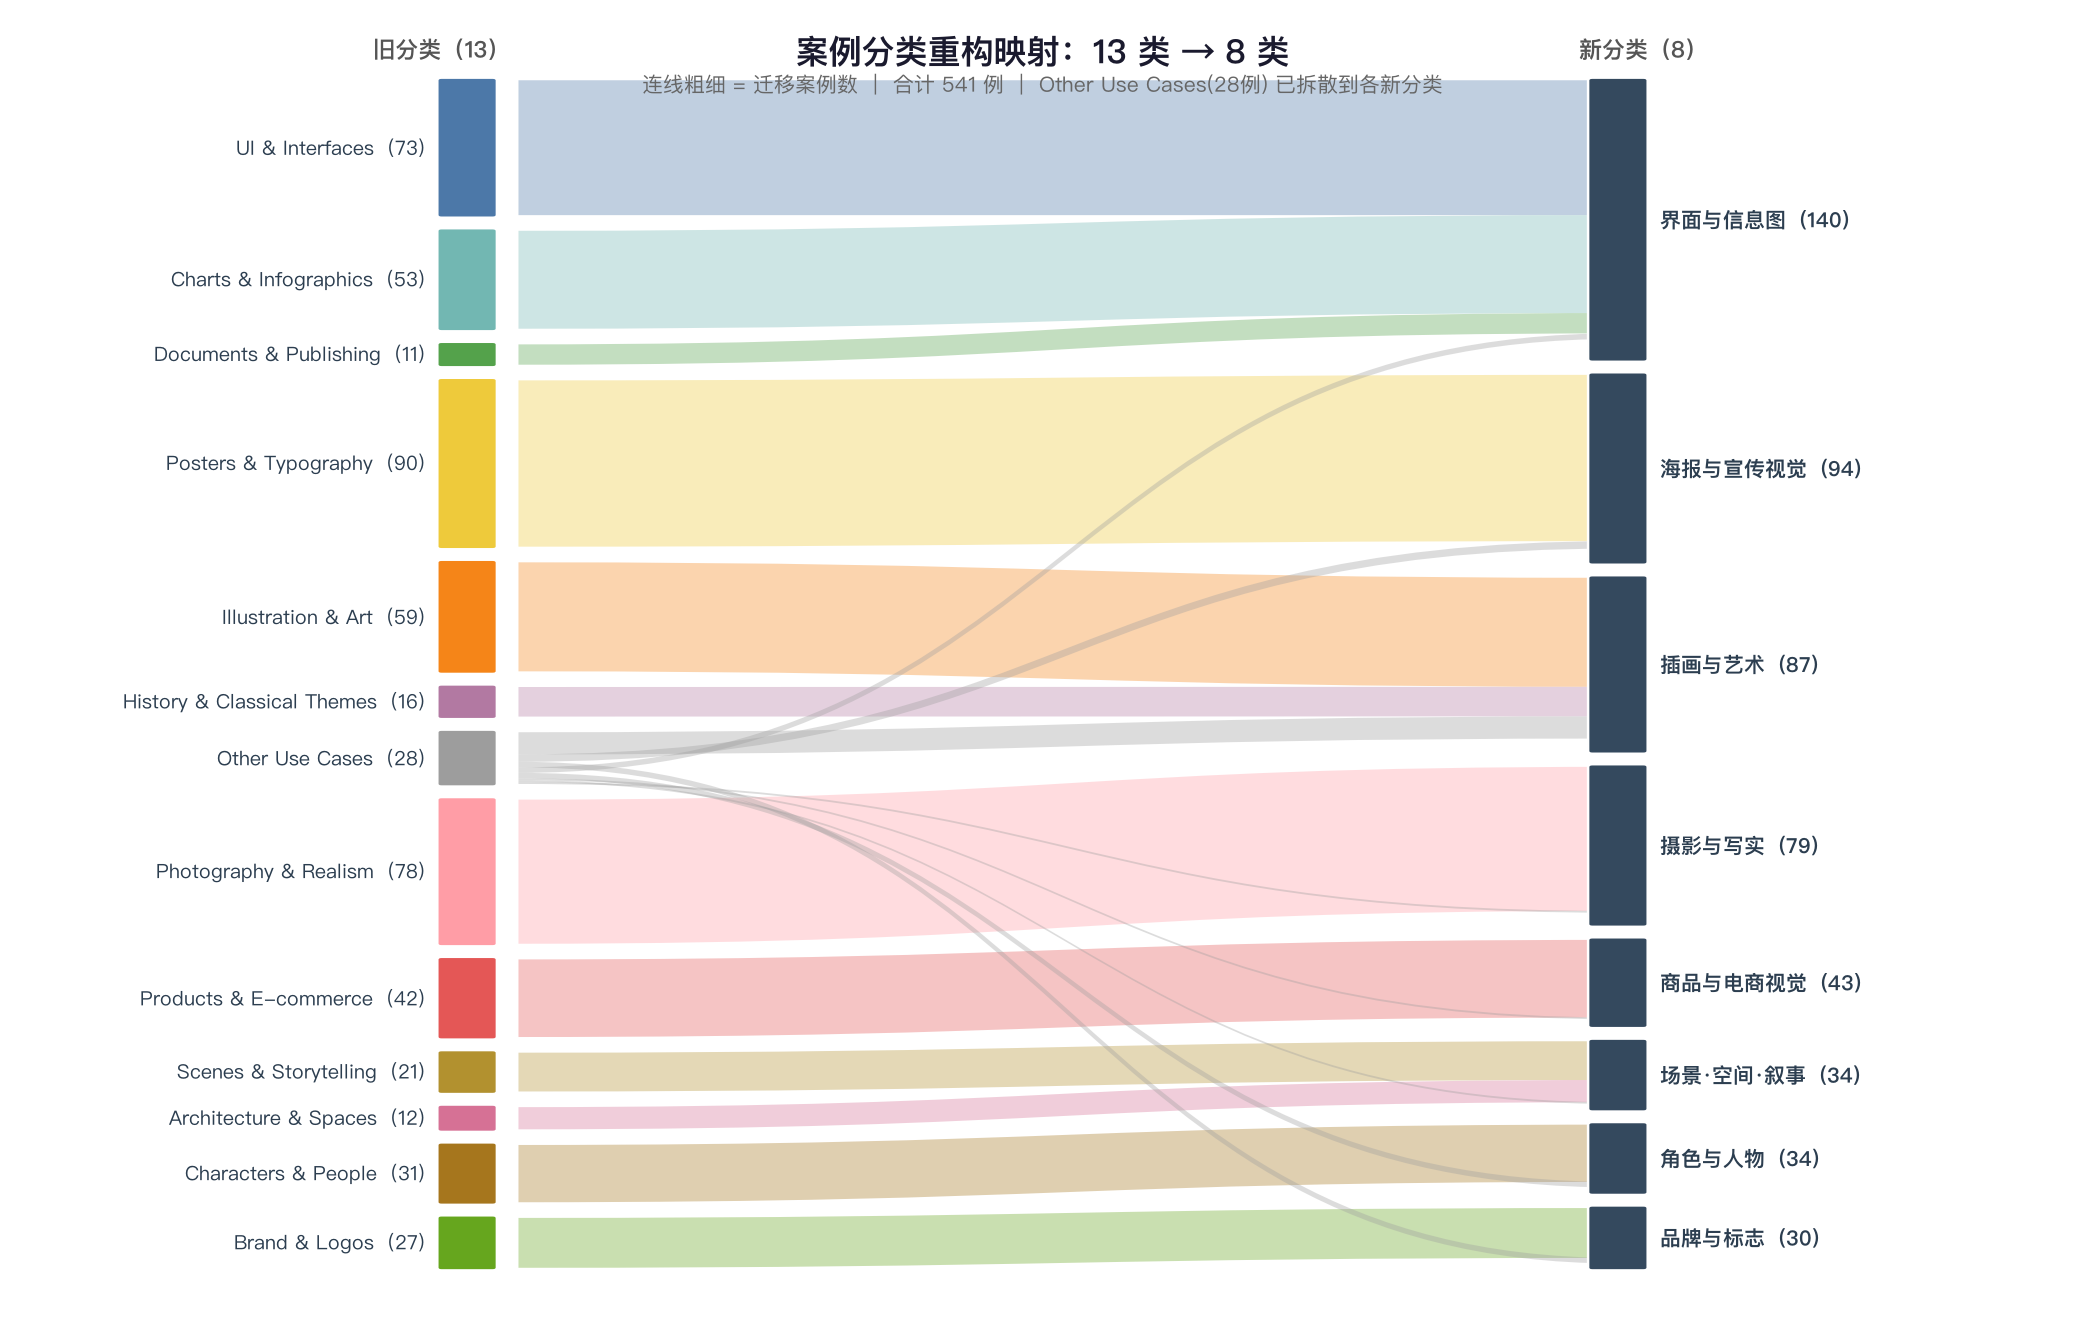
图4-第1张|展示新旧分类映射的桑基图(Sankey)
合并逻辑:该怎么分类
- 界面与信息图:UI 界面、Dashboard、信息图、技术图解、白皮书在用户心智里都是"屏幕上/纸面上的结构化信息",而且大量 UI 案例自带图表,合在一起 140 个是最大类。
- 插画与艺术:国风/古风/水墨/历史题材本质是插画艺术风格(汉服、工笔画、剪纸),并入后既解决了 History 类太薄的问题,也让"国风"通过别名直接命中。
- 场景·空间·叙事:建筑空间、城市、故事板、世界场景都是"大空间/世界观"类产出物。
- 角色与人物:专指虚拟角色/卡牌/3D角色;真实人像归"摄影与写实",通过"人像/肖像/头像"标签跨类命中。
- Other Use Cases 拆散:28 个案例按内容逐条归入对应新分类,不再保留垃圾桶。
标签和别名:让用户搜什么都能找到
分类精简了,但搜索不能丢。豆包给每个分类配了**别名表。**用户会搜的中文词,全部映射到对应分类和标签:
- 搜"国风""古风""水墨"→ 插画与艺术 + Classical 标签
- 搜"人像""肖像""头像"→ 摄影与写实 + Realistic 标签
- 搜"Logo""VI""标志"→ 品牌与标志 + Brand 标签
- 搜"详情页""包装""主图"→ 商品与电商视觉 + Product 标签
风格标签也从 19 个压到 12 个(合并掉所有同义词),场景标签从 10 个压到 9 个。
图4-第2张|展示别名表的实际效果
第四步:把新分类同步到飞书知识库
分类设计好了,接下来就是落地到飞书知识库。这一步豆包也能帮你干,不用手动搬。
在飞书知识库里建新目录
我在飞书知识库里建了一个空间,叫「GPT-Image2 提示词库」,然后按 8 个新分类建了 8 个一级目录。每个目录下面再放对应的案例文档和模板。
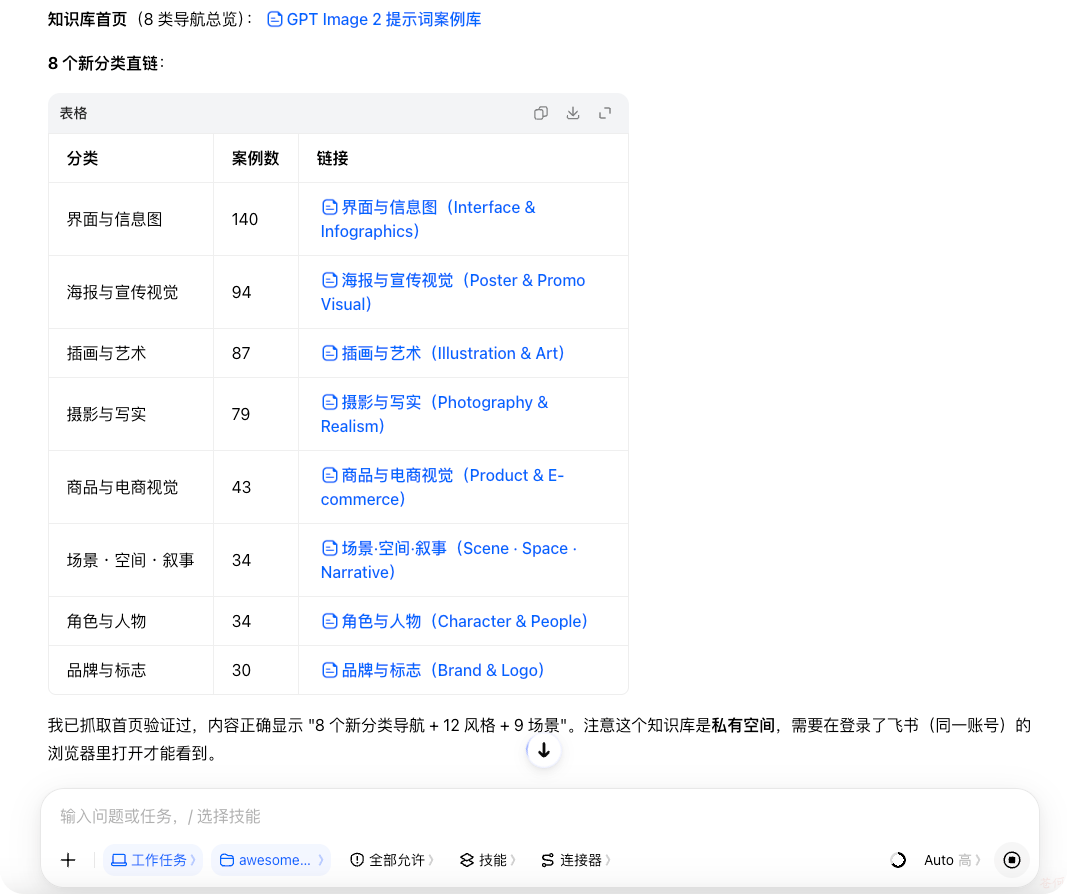
图5-第1张|飞书知识库的目录树界面
让豆包批量迁移到知识库管理
我给豆包的指令是这样的:
按照新分类映射表,把 cases.json 里的 541 个案例重新打 category 标签
然后按 8 个分类批量创建飞书文档,放到对应的知识库目录下
旧的分类锚点保留跳转,不要删
豆包会进行如下操作:
- 批量改写
cases.json的 category 字段(按映射表) - 调用飞书接口批量创建文档,自动归到对应目录
- 旧的 URL 锚点(比如
#cat-ui)保留 301 跳转,收藏的旧链接不会失效 - 案例 id 和图片路径保持不变,GitHub 上的链接不会断
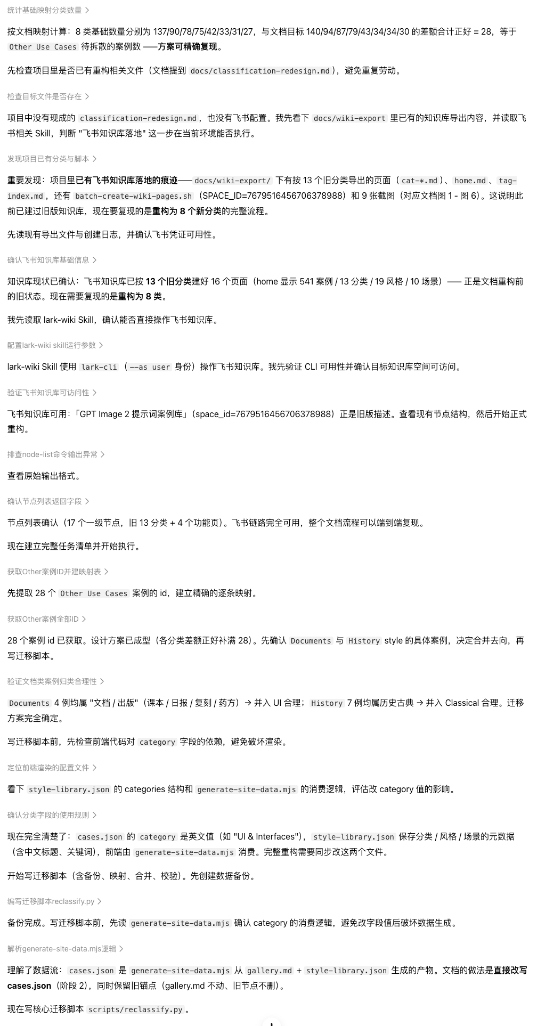
图5-第2张|展示豆包执行批量迁移的过程
这里有个小提醒:不要一次性全量改。我是分阶段来的,先改标签(低风险),再改分类(中风险),最后改前端展示和文档。每一步都能回滚,出了问题直接 Git 回退就行。
第五步:用真实查询测试
分类调整完成只是中间节点,核心目标是确认用户真的能更快找到目标内容。豆包帮我构造了 10 条真实查询做对比测试。
测试结果
| 真实查询 | 旧结构 | 新结构 |
|---|---|---|
| 国风水墨海报 | 在 History 和 Illustration 之间犹豫 | 直接插画与艺术,一步命中 |
| 写实人像 | 在 Photography 和 Characters 之间犹豫 | 进摄影与写实,别名"人像"直达 |
| APP界面截图 | 需要先判断是否属于UI类,UI分类内还混有Poster类内容形成干扰 | 直接进入界面与信息图 |
| 角色卡牌 | 3D 卡牌散在 Illustration 里 | 进入角色与人物,命中更集中 |
| 城市建筑地图 | 在 Architecture 和 Scenes 分类间来回犹豫 | 进入场景·空间·叙事 |
10条测试查询里,5条完全消除了用户在多个分类间反复跳转的犹豫,4条命中路径更短、结果更集中,剩余1条语义匹配精准度明显提升。整体用户查找内容的路径确定性大幅提高。
后续迭代:接入真实搜索词日志
说实话,这次重构用的"真实搜索词"是从541个案例的标题高频词反向推导出来的用户行为特征。目前网站已经完成GA4埋点部署,所有用户真实搜索词、零结果查询的完整数据都已经自动沉淀在GA4后台。
接下来我会直接从GA4导出全量真实搜索日志,基于真实用户行为再校准一次别名映射表。拿到真实数据后只需要微调别名规则,不需要推翻已经验证过的整体分类架构。
▶ 演示视频见开源仓库:https://github.com/AlephAITech/DoubaoWorkGuide
分阶段迁移清单
如果你也想做类似的重构,建议按这个节奏来,每一步独立可回滚:
| 阶段 | 做什么 | 风险 |
|---|---|---|
| 阶段 0 | 从 GA4 导出真实搜索词,校准别名表 | 只读,不改数据 |
| 阶段 1 | 合并同义标签(Characters→Character 等),只影响约 30 条 | 低 |
| 阶段 2 | 按映射表批量改写 category 字段,更新数据文件 | 中 |
| 阶段 3 | 更新前端展示:分类渲染、入口页、搜索别名、旧 URL 跳转 | 中 |
| 阶段 4 | 更新文档:README、gallery、templates 的分类标题和锚点 | 低 |
| 阶段 5 | 用真实查询跑回归,对比零结果查询是否下降 | 验证 |
写在最后
整个流程跑下来,最大的感受是:知识库管理这件事,以前觉得是体力活,现在变成了动动嘴的事。
豆包负责读数据、跑统计、找问题、设计方案、批量迁移,我只需要在关键节点做判断和确认。飞书知识库负责承载最终成果,让分类后的内容真正可搜索、可复用、可维护。
541个案例从之前散落在各个角落的零散文件,直接转化成了一套完全按照用户真实搜索心智组织起来的可复用知识资产。老项目沉淀的经验不用一直闲置,用AI搭配飞书知识库把它盘活,落地过程比想象中要顺利很多。
欢迎star我的项目地址:awesome-gpt-image-2